Your First Library for Bayesian Machine Learning#
BayesMLは、ベイズ統計学やベイズ決定理論に基づく機械学習の教育、研究、活用を促進し、社会に広く貢献することを目的としたライブラリです。
特徴#
使いやすい
ライブラリをインポートするだけで実装済みのベイズ統計モデルを使用できます。PyMCやStanのように自分でモデルを定義する必要はありません。
ベイズ決定理論に基づくAPI
BayesMLのAPIは、ベイズ決定理論に基づく意思決定の構造に対応しています。ベイズ決定理論は、パラメータ推定や新しいデータの予測など、様々な意思決定のプロセスを扱うための統一的なフレームワークです。そのためBayesMLでは、scikit-learnなどのライブラリで採用されているfit-predict型のAPIと比較して、より幅広い意思決定に対して直感的な操作が可能です。さらに、BayesMLのモデルの多くもfit-predict関数を実装しています。
モデル可視化機能
すべてのパッケージは、確率的データ生成モデル、そのモデルから生成されたデータ、そのデータから学習された事後分布を2~3次元空間で可視化するメソッドを持っています。このように、人工データの生成とそのデータからの学習を通して、確率的データ生成モデルやアルゴリズムの特徴を効果的に理解することができます。
共役事前分布を用いた高速アルゴリズム
BayesMLの学習アルゴリズムの多くは、確率的データ生成モデルと事前分布の共役性を効果的に利用する厳密計算法や変分ベイズ法を採用しています。そのため、汎用のMCMC法よりもはるかに高速であり、オンライン学習にも適しています。MCMC法を採用したアルゴリズムもありますが、共役性を利用してモデルごとに特化したMCMC法を用いています。
ニュース#
インストール手順#
BayesMLをインストールするには、以下のコマンドを使用してください。
pip install bayesml
以下が必要です。
Python (>= 3.10)
NumPy (>= 1.20)
SciPy (>= 1.7)
MatplotLib (>= 3.5)
Scikit-learn (>= 1.1)
チュートリアル#
BayesMLの各モデルには2つのクラスがあります。一つは GenModel で、事前分布や事後分布からパラメータを生成したり、データを生成したりします。もう一つは LearnModel であり、データから事後分布を推定したり、予測分布を計算したりすることができます。それぞれベイズ決定理論に沿ったAPIを持っています。ここでは linearregression モデルを例に、それぞれの使い方を紹介します。
GenModel による人工データ生成#
まず、以下のライブラリをインポートします。
import numpy as np
from bayesml import linearregression
次に、確率的データ生成モデルのインスタンスを作成します。ここでは、モデルの定数として回帰係数(定数項を含む)の次元を c_degree=2 と指定し、パラメータとして回帰係数を theta_vec = np.array([1,1]) と指定します。また、ノイズ項にはガウス分布(正規分布)を仮定し、平均を0、精度(分散の逆数)を tau = 10 とします。
gen_model = linearregression.GenModel(
    c_degree = 2, # degree
    theta_vec = np.array([1,1]), # coefficients
    tau = 10, # noise precision
)
作成したモデルの特徴は、以下の方法で可視化できます。
gen_model.visualize_model()
出力
theta_vec:[1. 1.]tau:10.0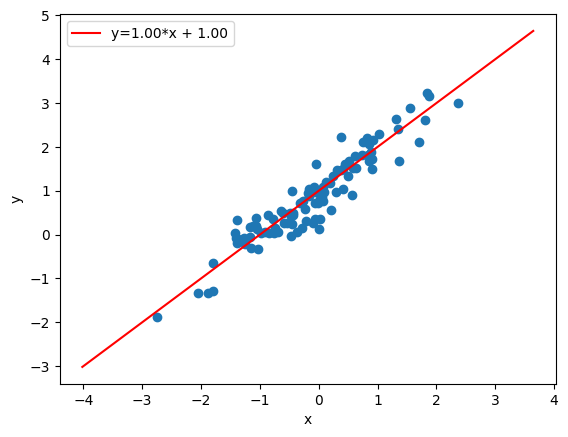
サンプルを生成して変数 x と y に保存するには、以下のメソッドを使います。
x,y = gen_model.gen_sample(sample_size=100)
また、後で使用するためのテストデータも生成しておきましょう。
x_test,y_test = gen_model.gen_sample(sample_size=100)
LearnModel による学習と意思決定#
それでは LearnModel を使って、先ほど生成したデータからモデルを学習してみましょう。
もちろん、LearnModel で使用できるデータは GenModel から生成されたデータに限りません。実世界の様々なデータを分析することができます。
まず、学習モデルのインスタンスを作成しましょう。ここではモデルの定数として次数 c_degree = 2 だけを指定していますが、事前分布のハイパーパラメータを指定することもできます。
learn_model = linearregression.LearnModel(
    c_degree = 2, # degree
)
パラメータの事後分布を可視化するメソッドは LearnModel に実装されています。この時点で事後分布を可視化すると、データからの学習がまだ行われていないため、事前分布が表示されます。
learn_model.visualize_posterior()
出力
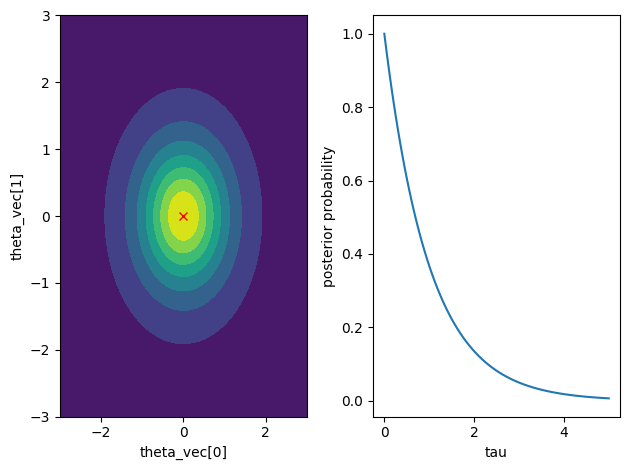
データから学習して事後分布を更新するには、以下のメソッドを使います。
learn_model.update_posterior(x,y)
更新された事後分布を可視化すると、事後分布の確率密度が x と y の生成に使われた真のパラメータに近づいていることがわかります。
learn_model.visualize_posterior()
出力
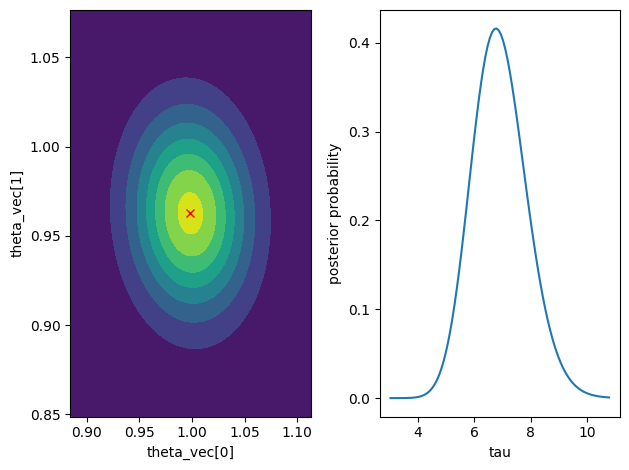
学習したモデルに基づいてパラメータ推定や新しいデータの予測などの判断を行う手順は、以下の通りです。
パラメータ推定には estimate_params メソッドを使用します。 loss オプションに squared を指定することで、二乗誤差損失関数に基づくベイズリスク関数を最小化する推定値を得ることができます。結果の値は事後分布の期待値(平均)となります。
learn_model.estimate_params(loss="squared",dict_out=True)
出力
{'theta_vec': array([0.99846525, 0.96263024]), 'tau': 6.9036925167513195}
loss オプションに abs を指定すると、絶対誤差損失関数に基づくベイズリスク関数を最小化する推定値を得ることができます。その結果得られる値は事後分布の中央値(メジアン)となり、そのため tau の推定値は先ほどとは異なります。
learn_model.estimate_params(loss="abs",dict_out=True)
出力
{'theta_vec': array([0.99846525, 0.96263024]), 'tau': 6.858623148933392}
新しいデータを予測するために、まず新しい説明変数の予測分布を計算するための以下のメソッドを使います。
learn_model.calc_pred_dist(x_test)
次に make_prediction メソッドを使って予測値を求めます。パラメータ推定と同様に、 loss オプションで損失関数を指定することができます(この例では、事後予測分布が対称的であるため、二乗誤差損失を仮定しても、絶対誤差損失を仮定しても、同じ予測値が返されます)。
y_pred = learn_model.make_prediction(loss="squared")
平均二乗誤差を計算してみましょう。
mse = np.sum((y_test - y_pred)**2) / len(y_test)
print(f"MSE: {mse}")
出力
MSE: 0.09020880284291456
データ生成に使用したノイズ項の精度(分散の逆数)が10であることを考慮すると、十分な精度で予測が達成されていることがわかります。
GenModel を用いた事後分布からのサンプリング#
GenModel は LearnModel によって学習された事後分布からパラメータをサンプリングしたり、事後予測分布から新しいデータをサンプリングするために使用することができます。
まず、LearnModel によって学習された事後分布のハイパーパラメータは以下のように求めることができます。
hn_params = learn_model.get_hn_params()
print(hn_params)
出力
{'hn_mu_vec': array([0.99846525, 0.96263024]), 'hn_lambda_mat': array([ [ 99.87503339, 5.96145913], [ 5.96145913, 101. ]]), 'hn_alpha': 51.0, 'hn_beta': 7.387351026461872}
これらを GenModel に渡すことで、事後分布からパラメータをサンプリングすることができます。
パラメータサンプリングのために新しい GenModel インスタンスを作成し、 set_h_params メソッドを通してハイパーパラメータを渡します。(以下の例では、hn_params.values() に * を用いて辞書 hn_params の値を展開(アンパック)しています。これは Python の機能であり、BayesML の機能ではありません)。
posterior_gen_model = linearregression.GenModel(
    c_degree = 2, # degree
)
posterior_gen_model.set_h_params(*hn_params.values())
パラメータの生成には gen_params メソッドを使用し、生成されたパラメータを取得するには get_params メソッドを使用します。複数のサンプリングを行いたい場合は、 for ループの中で以下を繰り返してください。
posterior_gen_model.gen_params()
print(posterior_gen_model.get_params())
出力
{'theta_vec': array([1.00935782, 0.93804208]), 'tau': 5.50775630793475}
事後予測分布から新しいデータをサンプリングするために、パラメータをサンプリングした後にデータを生成します。人工データを生成する際、gen_sample の引数に説明変数を指定しませんでしたが、以下のように明示的に指定することもできます。
posterior_gen_model.gen_params()
_,y_new = posterior_gen_model.gen_sample(x=x_test[:10])
print(f"y_new: {y_new}")
出力
y_new: [-0.49532975 2.03473075 1.13758759 -0.46735058 -0.71902336 -0.09288005 0.89463227 2.07886012 2.81211771 1.60020635]
パッケージリスト#
現在、以下のパッケージが利用可能です。本ライブラリでは、確率的データ生成モデル、事前分布、事後分布(または近似事後分布)、 予測分布(または近似予測分布)を総称してモデルと呼びます。
将来的には、より複雑な階層モデルを扱うためのパッケージを追加する予定です。
引用#
BayesMLを学術研究に利用する場合は、以下のとおり引用をお願いいたします。
Plain text
Y. Nakahara, N. Ichijo, K. Shimada, Y. Iikubo,
S. Saito, K. Kazama, T. Matsushima, BayesML Developers, ``BayesML,''
Python package version 0.5.1, 2026.
[Online] https://github.com/bayesml/BayesML
BibTeX
@misc{bayesml,
author = {Nakahara, Yuta and Ichijo, Naoki and Shimada, Koshi and
          Iikubo, Yuji and Saito, Shota and Kazama, Koki and
          Matsushima, Toshiyasu and {BayesML Developers}},
title = {{BayesML}},
howpublished = {Python package version 0.5.1},
note = {\url{https://github.com/bayesml/BayesML}},
year = {2026}
}
GitHubスターのお願い#
