bayesml.multivariate_normal package#
モジュール内容#
このモジュールでは正規・ウィシャート事前分布を持つ多変量正規分布を利用できます。
確率的データ生成モデル#
確率的データ生成モデルは以下の通りです:
\(D \in \mathbb{N}\): データの次元
\(\boldsymbol{x} \in \mathbb{R}^D\): データ点
\(\boldsymbol{\mu} \in \mathbb{R}^D\): パラメータ
\(\boldsymbol{\Lambda} \in \mathbb{R}^{D\times D}\) : パラメータ(正定値行列)
\(| \boldsymbol{\Lambda} | \in \mathbb{R}\): :math:`boldsymbol{Lambda}`の行列式
事前分布#
事前分布は以下の通りです:
\(\boldsymbol{m}_0 \in \mathbb{R}^{D}\): ハイパーパラメータ
\(\kappa_0 \in \mathbb{R}_{>0}\): ハイパーパラメータ
\(\nu_0 \in \mathbb{R}\): ハイパーパラメータ(\(\nu_0 > D-1\))
\(\boldsymbol{W}_0 \in \mathbb{R}^{D\times D}\): ハイパーパラメータ(正定値行列)
\(\mathrm{Tr} \{ \cdot \}\): 行列のトレース
\(\Gamma (\cdot)\): ガンマ関数
ここで、\(B(\boldsymbol{W}_0, \nu_0)\) は次のように定義されます:
事後分布#
事後分布は以下の通りです:
\(\boldsymbol{x}^n = (\boldsymbol{x}_1, \boldsymbol{x}_2, \dots , \boldsymbol{x}_n) \in \mathbb{R}^{D\times n}\): 与えられたデータ
\(\boldsymbol{m}_n \in \mathbb{R}^{D}\): ハイパーパラメータ
\(\kappa_n \in \mathbb{R}_{>0}\): ハイパーパラメータ
\(\nu_n \in \mathbb{R}\): ハイパーパラメータ \((\nu_n > D-1)\)
\(\boldsymbol{W}_n \in \mathbb{R}^{D\times D}\): ハイパーパラメータ(正定値行列)
ここでハイパーパラメータの更新式は以下で与えられます
予測分布#
予測分布は以下の通りです:
\(\boldsymbol{x}_{n+1}\in \mathbb{R}^d\): 新たなデータ点
\(\boldsymbol{\mu}_\mathrm{p} \in \mathbb{R}^D\): 予測分布のハイパーパラメータ
\(\boldsymbol{\Lambda}_\mathrm{p} \in \mathbb{R}^{D \times D}\): 予測分布のハイパーパラメータ(正定値行列)
\(\nu_\mathrm{p} \in \mathbb{R}_{>0}\): 予測分布のハイパーパラメータ
ここで、パラメータは事後分布のハイパーパラメータから以下のように求められます:
GitHubスターのお願い#

クラス#
- class bayesml.multivariate_normal.GenModel(c_degree, mu_vec=None, lambda_mat=None, h_m_vec=None, h_kappa=1.0, h_nu=None, h_w_mat=None, seed=None)#
ベースクラス:
Generative確率的データ生成モデルと事前分布
- パラメータ:
- c_degreeint
正の整数。
- mu_vecnumpy.ndarray, optional
実数のベクトルで、デフォルトでは [0.0, 0.0, ..., 0.0] となります
- lambda_matnumpy.ndarray, optional
正定値対称行列。デフォルトでは単位行列です
- h_m_vecnumpy.ndarray, optional
実数のベクトルで、デフォルトでは [0.0, 0.0, ..., 0.0] となります
- h_kappafloat, optional
正の実数、デフォルトでは1.0です
- h_nufloat, optional
a real number > c_degree-1, by default the value of
c_degree- h_w_matnumpy.ndarray, optional
正定値対称行列。デフォルトでは単位行列です
- seed{None, int}, optional
numpy.random.default_rng() を初期化するシード値です。デフォルトでは None
メソッド
事前分布からパラメータを生成します。
gen_sample(sample_size)確率的データ生成モデルからサンプルを生成します。
GenModel の定数を取得します。
事前分布のハイパーパラメータを取得します。
確率的データ生成モデルのパラメータを取得します。
load_h_params(filename)h_paramsにハイパーパラメータをロードします。
load_params(filename)Load the parameters saved by
save_params.save_h_params(filename)python
pickleモジュールを使ってハイパーパラメータを保存します。save_params(filename)python の
pickleモジュールを使ってパラメータを保存します。save_sample(filename, sample_size)生成されたサンプルを NumPy
.npzフォーマットで保存します。set_h_params([h_m_vec, h_kappa, h_nu, h_w_mat])事前分布のハイパーパラメータを設定します。
set_params([mu_vec, lambda_mat])確率的データ生成モデルのパラメータを設定します。
visualize_model([sample_size])確率的データ生成モデルと生成されたサンプルを可視化します。
- get_constants()#
GenModel の定数を取得します。
- 返り値:
- constantsdict of {str: int}
"c_degree":``self.c_degree``の値
- set_h_params(h_m_vec=None, h_kappa=None, h_nu=None, h_w_mat=None)#
事前分布のハイパーパラメータを設定します。
- パラメータ:
- h_m_vecnumpy.ndarray, optional
実数のベクトル、デフォルトではNone
- h_kappafloat, optional
正の実数、デフォルトではNone
- h_nufloat, optional
a real number > c_degree-1, by default None
- h_w_matnumpy.ndarray, optional
正定値対称行列。デフォルトはNoneです
- get_h_params()#
事前分布のハイパーパラメータを取得します。
- gen_params()#
事前分布からパラメータを生成します。
生成された値は、
self.mu_vecおよびself.lambda_matに設定されます。
- set_params(mu_vec=None, lambda_mat=None)#
確率的データ生成モデルのパラメータを設定します。
- パラメータ:
- mu_vecnumpy.ndarray, optional
実数のベクトル、デフォルトではNone
- lambda_matnumpy.ndarray, optional
正定値対称行列。デフォルトはNoneです
- get_params()#
確率的データ生成モデルのパラメータを取得します。
- 返り値:
- params{str:float, numpy.ndarray}
"mu_vec":self.mu_vecの値"lambda_mat":``self.lambda_mat``の値
- gen_sample(sample_size)#
確率的データ生成モデルからサンプルを生成します。
- パラメータ:
- sample_sizeint
正の整数
- 返り値:
- xnumpy ndarray
形状が「(sammple_size,c_degree)」で、要素が実数である2次元配列です。
- save_sample(filename, sample_size)#
生成されたサンプルを NumPy
.npzフォーマットで保存します。キーワード "x "でNpzFileとして保存されます。
- パラメータ:
- filenamestr
サンプルを保存するファイル名。ない場合は
.npzが追加されます。- sample_sizeint
正の整数
- visualize_model(sample_size=100)#
確率的データ生成モデルと生成されたサンプルを可視化します。
- パラメータ:
- sample_sizeint, オプション
正の整数(デフォルトは1)
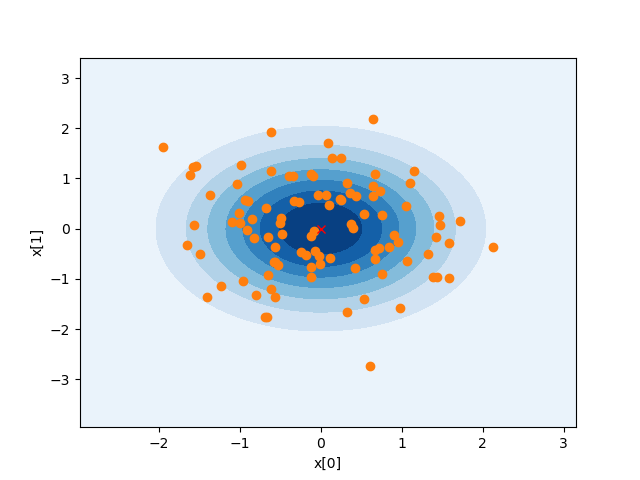
例
>>> from bayesml import multivariate_normal
>>> model = multivariate_normal.GenModel(c_degree=2)
>>> model.visualize_model()
mu:
[0. 0.]
lambda_mat:
[[1. 0.]
 [0. 1.]]
- class bayesml.multivariate_normal.LearnModel(c_degree, h0_m_vec=None, h0_kappa=1.0, h0_nu=None, h0_w_mat=None)#
ベースクラス:
Posterior,PredictiveMixin事後分布と予測分布
- パラメータ:
- c_degreeint
正の整数。
- h0_m_vecnumpy.ndarray, optional
実数のベクトルで、デフォルトでは [0.0, 0.0, ..., 0.0] となります
- h0_kappafloat, optional
正の実数、デフォルトでは1.0です
- h0_nufloat, optional
a real number > c_degree-1, by default the value of
c_degree- h0_w_matnumpy.ndarray, optional
正定値対称行列。デフォルトでは単位行列です
- 属性:
- h0_w_mat_invnumpy.ndarray
h0_w_mat の逆行列
- hn_m_vecnumpy.ndarray
実数のベクトル
- hn_kappafloat
正の実数
- hn_nufloat
実数
- hn_w_matnumpy.ndarray
正定値対称行列
- hn_w_mat_invnumpy.ndarray
hn_w_mat の逆行列
- p_m_vecnumpy.ndarray
実数のベクトル
- p_nufloat, optional
正の実数
- p_v_matnumpy.ndarray
正定値対称行列
- p_v_mat_invnumpy.ndarray
p_v_mat の逆行列
メソッド
予測分布のパラメータを計算します。
estimate_params([loss, dict_out])与えられた基準の下で、確率的データ生成モデルのパラメータを推定します。
fit(x)モデルをデータに当てはめます。
LearnModel の定数を取得します。
事後分布のハイパーパラメータの初期値を取得します。
事後分布のハイパーパラメータを取得します。
予測分布のパラメータを取得します。
load_h0_params(filename)h0_paramsにハイパーパラメータをロードします。
load_hn_params(filename)hn_paramsにハイパーパラメータをロードします。
make_prediction([loss])与えられた基準の下で、新しいデータ点を予測します。
overwrite_h0_params()事後分布のハイパーパラメータの初期値を学習した値で上書きします。
pred_and_update(x[, loss])逐次的に新しいデータ点を予測し、事後分布を更新します。
predict()次のデータ点を予測します。
reset_hn_params()事後分布のハイパーパラメータを初期値に戻します。
save_h0_params(filename)python
pickleモジュールを使ってハイパーパラメータを保存します。save_hn_params(filename)python
pickleモジュールを使ってハイパーパラメータを保存します。set_h0_params([h0_m_vec, h0_kappa, h0_nu, ...])事前分布のハイパーパラメータを設定します。
set_hn_params([hn_m_vec, hn_kappa, hn_nu, ...])事後分布のハイパーパラメータの更新値を設定します。
訓練データを使って事後分布のハイパーパラメータを更新します。
パラメータの事後分布を可視化します。
- get_constants()#
LearnModel の定数を取得します。
- 返り値:
- constantsdict of {str: int}
"c_degree":``self.c_degree``の値
- set_h0_params(h0_m_vec=None, h0_kappa=None, h0_nu=None, h0_w_mat=None)#
事前分布のハイパーパラメータを設定します。
- パラメータ:
- h0_m_vecnumpy.ndarray, optional
実数のベクトル、デフォルトではNone
- h0_kappafloat, optional
正の実数、デフォルトではNone
- h0_nufloat, optional
a real number > c_degree-1, by default None
- h0_w_matnumpy.ndarray, optional
正定値対称行列。デフォルトはNoneです
- get_h0_params()#
事後分布のハイパーパラメータの初期値を取得します。
- set_hn_params(hn_m_vec=None, hn_kappa=None, hn_nu=None, hn_w_mat=None)#
事後分布のハイパーパラメータの更新値を設定します。
- パラメータ:
- hn_m_vecnumpy.ndarray, optional
実数のベクトル、デフォルトではNone
- hn_kappafloat, optional
正の実数、デフォルトではNone
- hn_nufloat, optional
a real number > c_degree-1, by default None
- hn_w_matnumpy.ndarray, optional
正定値対称行列。デフォルトはNoneです
- get_hn_params()#
事後分布のハイパーパラメータを取得します。
- update_posterior(x)#
訓練データを使って事後分布のハイパーパラメータを更新します。
- パラメータ:
- xnumpy.ndarray
すべての要素は実数でなければなりません。
- estimate_params(loss='squared', dict_out=False)#
与えられた基準の下で、確率的データ生成モデルのパラメータを推定します。
この基準は、「mu_vec」と「lambda_mat」を個別に推定する際に適用される点にご注意ください。したがって、loss="KL" の場合、スチューデントの t 分布とウィシャートの分布のタプルが返されます。
- パラメータ:
- lossstr, optional
ベイズリスク関数の基礎となる損失関数は、デフォルトで「二乗誤差損失」となります。この関数は「二乗誤差損失」、「0-1損失」、「KL」をサポートしております。
- dict_outbool, optional
If
True, output will be a dict, by defaultFalse.
- 返り値:
- estimatestuple of {numpy ndarray, float, None, or rv_frozen}
mu_vec_hat:mu_vec の推定値lambda_mat_hat:lambda_mat の推定値
与えられた損失関数の下での推定値。存在しない場合は None が返されます。損失関数が "KL" の場合、事後分布そのものが scipy.stats の rv_frozen オブジェクトとして返されます。
- visualize_posterior()#
パラメータの事後分布を可視化します。
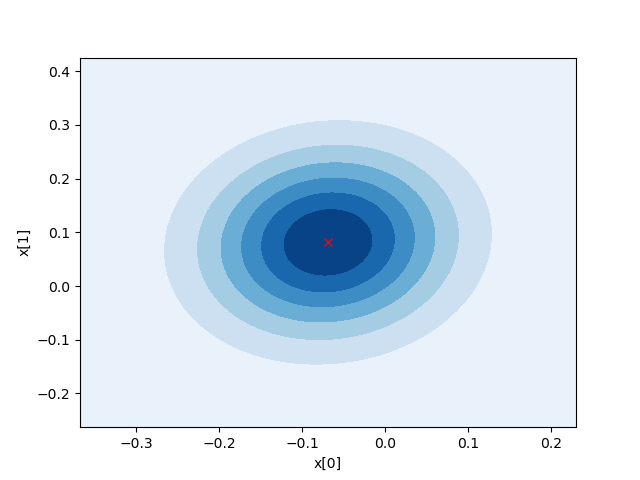
例
>>> from bayesml import multivariate_normal
>>> gen_model = multivariate_normal.GenModel(c_degree=2)
>>> x = gen_model.gen_sample(100)
>>> learn_model = multivariate_normal.LearnModel(c_degree=2)
>>> learn_model.update_posterior(x)
>>> learn_model.visualize_posterior()
hn_m_vec:
[-0.06924909  0.08126454]
hn_kappa:
101.0
hn_nu:
102.0
hn_w_mat:
[[ 0.00983415 -0.00059828]
[-0.00059828  0.00741698]]
E[lambda_mat]=
[[ 1.0030838  -0.06102455]
[-0.06102455  0.7565315 ]]
- get_p_params()#
予測分布のパラメータを取得します。
- calc_pred_dist()#
予測分布のパラメータを計算します。
- make_prediction(loss='squared')#
与えられた基準の下で、新しいデータ点を予測します。
- パラメータ:
- lossstr, optional
ベイズリスク関数の基礎となる損失関数は、デフォルトで「二乗誤差損失」となります。この関数は「二乗誤差損失」、「0-1損失」、「KL」をサポートしております。
- 返り値:
- Predicted_value{numpy.ndarray, rv_frozen}
指定された損失関数における予測値です。損失関数が「KL」の場合、事後分布そのものが scipy.stats の rv_frozen オブジェクトとして返されます。
- pred_and_update(x, loss='squared')#
逐次的に新しいデータ点を予測し、事後分布を更新します。
- パラメータ:
- xnumpy.ndarray
それはc次元のベクトルでなければなりません
- lossstr, optional
ベイズリスク関数の基礎となる損失関数は、デフォルトで「二乗誤差損失」となります。この関数は「二乗誤差損失」、「0-1損失」、「KL」をサポートしております。
- 返り値:
- Predicted_value{numpy.ndarray, rv_frozen}
指定された損失関数における予測値です。損失関数が「KL」の場合、事後分布そのものが scipy.stats の rv_frozen オブジェクトとして返されます。
- fit(x)#
モデルをデータに当てはめます。
この関数は以下の関数のラッパーです:
>>> self.reset_hn_params()
>>> self.update_posterior(x)
>>> return self
- パラメータ:
- xnumpy.ndarray
すべての要素は実数でなければなりません。
- 返り値:
- selfLearnModel
The fitted model.
- predict()#
次のデータ点を予測します。
この関数は以下の関数のラッパーです:
>>> self.calc_pred_dist()
>>> return self.make_prediction(loss="squared")
- 返り値:
- predicted_valuenumpy.ndarray
二乗誤差関数に基づく予測値。