bayesml.autoregressive package#
モジュール内容#
このモジュールでは正規ガンマ事前分布を用いた線形自己回帰モデルを利用できます。
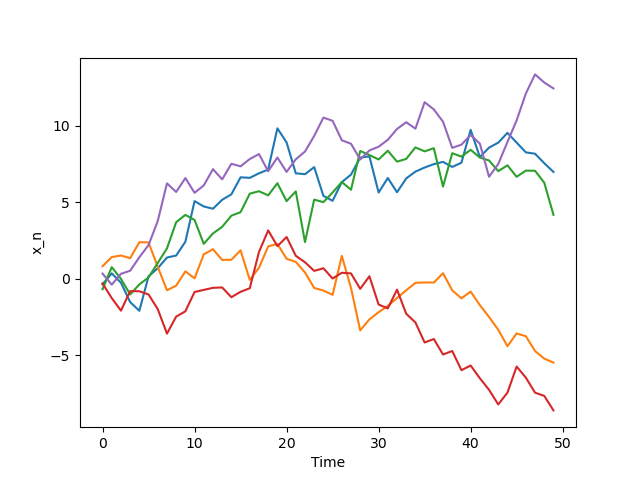
確率的データ生成モデル#
確率的データ生成モデルは以下の通りです:
\(d \in \mathbb{N}\): モデルの次数
\(n \in \mathbb{N}\): 時間インデックス
\(x_n \in \mathbb{R}\): 時点 \(n\) におけるデータ点
\(\boldsymbol{x}'_n := [1, x_{n-d}, x_{n-d+1}, \dots , x_{n-1}]^\top \in \mathbb{R}^{d+1}\)。ここで、\(n < 1\) に対する \(x_n\) は初期値として与えられているものと仮定します。
\(\boldsymbol{\theta} \in \mathbb{R}^{d+1}\): 回帰係数パラメータ
\(\tau \in \mathbb{R}_{>0}\): ノイズの精度パラメータ
事前分布#
事前分布は以下の通りです:
\(\boldsymbol{\mu}_0 \in \mathbb{R}^{d+1}\): \(\boldsymbol{\theta}\) のハイパーパラメータ
\(\boldsymbol{\Lambda}_0 \in \mathbb{R}^{(d+1) \times (d+1)}\): \(\boldsymbol{\theta}\) のハイパーパラメータ(正定値行列)
\(| \boldsymbol{\Lambda}_0 | \in \mathbb{R}\): \(\boldsymbol{\Lambda}_0\) の行列式
\(\alpha_0 \in \mathbb{R}_{>0}\): \(\tau\) のハイパーパラメータ
\(\beta_0 \in \mathbb{R}_{>0}\): \(\tau\) のハイパーパラメータ
\(\Gamma(\cdot): \mathbb{R}_{>0} \to \mathbb{R}\): ガンマ関数
事後分布#
事後分布は以下の通りです:
\(x^n := [x_1, x_2, \dots , x_n]^\top \in \mathbb{R}^n\): 与えられたデータ
\(\boldsymbol{X}_n = [\boldsymbol{x}'_1, \boldsymbol{x}'_2, \dots , \boldsymbol{x}'_n]^\top \in \mathbb{R}^{n \times (d+1)}\)
\(\boldsymbol{\mu}_n \in \mathbb{R}^{d+1}\): \(\boldsymbol{\theta}\) のハイパーパラメータ
\(\boldsymbol{\Lambda}_n \in \mathbb{R}^{(d+1) \times (d+1)}\): \(\boldsymbol{\theta}\) のハイパーパラメータ(正定値行列)
\(\alpha_n \in \mathbb{R}_{>0}\): \(\tau\) のハイパーパラメータ
\(\beta_n \in \mathbb{R}_{>0}\): \(\tau\) のハイパーパラメータ
ただし、ハイパーパラメータの更新ルールは次の通りです
予測分布#
予測分布は以下の通りです:
\(x_{n+1} \in \mathbb{R}\): 新たなデータ点
\(m_\mathrm{p} \in \mathbb{R}\): パラメータ
\(\lambda_\mathrm{p} \in \mathbb{R}_{>0}\): パラメータ
\(\nu_\mathrm{p} \in \mathbb{R}_{>0}\): パラメータ
ここで、パラメータは事後分布のハイパーパラメータから以下のように求められます。
GitHubスターのお願い#

クラス#
- class bayesml.autoregressive.GenModel(c_degree, theta_vec=None, tau=1.0, h_mu_vec=None, h_lambda_mat=None, h_alpha=1.0, h_beta=1.0, seed=None)#
ベースクラス:
Generative確率的データ生成モデルと事前分布
- パラメータ:
- c_degreeint
正の整数。
- theta_vecnumpy ndarray, optional
実数のベクトルであり、定数項を含みます。デフォルトでは [0.0, 0.0, ..., 0.0] となります。
- taufloat, optional
正の実数、デフォルトでは1.0です
- h_mu_vecnumpy ndarray, optional
実数のベクトルで、デフォルトでは [0.0, 0.0, ..., 0.0] となります
- h_lambda_matnumpy ndarray, optional
正定値行列、デフォルトでは単位行列
- h_alphafloat, optional
正の実数、デフォルトでは1.0です
- h_betafloat, optional
正の実数、デフォルトでは1.0です
- seed{None, int}, optional
numpy.random.default_rng() を初期化するシード値です。デフォルトでは None
メソッド
事前分布からパラメータを生成します。
gen_sample(sample_length[, initial_values])確率的データ生成モデルからサンプルを生成します。
GenModel の定数を取得します。
事前分布のハイパーパラメータを取得します。
確率的データ生成モデルのパラメータを取得します。
load_h_params(filename)h_paramsにハイパーパラメータをロードします。
load_params(filename)``save_paramsで保存したパラメータを読み込みます。
save_h_params(filename)python
pickleモジュールを使ってハイパーパラメータを保存します。save_params(filename)python の
pickleモジュールを使ってパラメータを保存します。save_sample(filename, sample_length[, ...])生成されたサンプルを NumPy
.npzフォーマットで保存します。set_h_params([h_mu_vec, h_lambda_mat, ...])事前分布のハイパーパラメータを設定します。
set_params([theta_vec, tau])確率的データ生成モデルのパラメータを設定します。
visualize_model([sample_length, sample_num, ...])確率的データ生成モデルと生成されたサンプルを可視化します。
- get_constants()#
GenModel の定数を取得します。
- 返り値:
- constantsdict of {str: int}
"c_degree":``self.c_degree``の値
- set_h_params(h_mu_vec=None, h_lambda_mat=None, h_alpha=None, h_beta=None)#
事前分布のハイパーパラメータを設定します。
- パラメータ:
- h_mu_vecnumpy ndarray, optional
実数のベクトル、デフォルトではNone
- h_lambda_matnumpy ndarray, optional
正定値行列、デフォルトではNone
- h_alphafloat, optional
正の実数、デフォルトではNone
- h_betafloat, optional
正の実数、デフォルトではNone
- get_h_params()#
事前分布のハイパーパラメータを取得します。
- 返り値:
- h_paramsdict of {str: float or numpy ndarray}
"h_mu_vec":self.h_mu_vecの値h_lambda_mat":self.h_lambda_matの値"h_alpha":self.h_alphaの値"h_beta":self.h_betaの値
- gen_params()#
事前分布からパラメータを生成します。
生成された値は``self.theta_vec``および``self.tau``に設定されます。
- set_params(theta_vec=None, tau=None)#
確率的データ生成モデルのパラメータを設定します。
- パラメータ:
- theta_vecnumpy ndarray, optional
実数のベクトル、デフォルトではNone
- taufloat, optional, optional
正の実数、デフォルトではNone
- get_params()#
確率的データ生成モデルのパラメータを取得します。
- 返り値:
- paramsdict of {str: float or numpy ndarray}
"theta_vec":self.theta_vecの値"tau":self.tauの値
- gen_sample(sample_length, initial_values=None)#
確率的データ生成モデルからサンプルを生成します。
- パラメータ:
- sample_lengthint
正の整数
- initial_valulesnumpy ndarray, optional
1次元の浮動小数点数配列で、そのサイズは``self.c_degree``と一致します。デフォルトではNoneです。
- 返り値:
- xnumpy ndarray
サンプル長が
sammple_lengthの1次元の浮動小数点数配列です。
- save_sample(filename, sample_length, initial_values=None)#
生成されたサンプルを NumPy
.npzフォーマットで保存します。キーワード "x "でNpzFileとして保存されます。
- パラメータ:
- filenamestr
サンプルを保存するファイル名。ない場合は
.npzが追加されます。- sample_lengthint
正の整数
- initial_valulesnumpy ndarray, optional
1次元の浮動小数点数配列で、そのサイズは``self.c_degree``と一致します。デフォルトではNoneです。
- visualize_model(sample_length=50, sample_num=5, initial_values=None)#
確率的データ生成モデルと生成されたサンプルを可視化します。
- パラメータ:
- sample_lengthint, オプション
正の整数、デフォルトは50です
- sample_numint, オプション
正の整数、デフォルトは5です
- initial_valulesnumpy ndarray, optional
1次元の浮動小数点数配列で、そのサイズは``self.c_degree``と一致します。デフォルトではNoneです。
例
>>> import numpy as np
>>> from bayesml import autoregressive
>>> model = autoregressive.GenModel(c_degree=1,theta_vec=np.array([0,1]))
>>> model.visualize_model()
theta_vec:[0,1]
tau:1.0
- class bayesml.autoregressive.LearnModel(c_degree, h0_mu_vec=None, h0_lambda_mat=None, h0_alpha=1.0, h0_beta=1.0)#
ベースクラス:
Posterior,PredictiveMixin事後分布と予測分布
- パラメータ:
- c_degreeint
正の整数。
- h0_mu_vecnumpy ndarray, optional
実数のベクトルで、デフォルトでは [0.0, 0.0, ..., 0.0] となります
- h0_lambda_matnumpy ndarray, optional
正定値行列、デフォルトでは単位行列
- h0_alphafloat, optional
正の実数、デフォルトでは1.0です
- h0_betafloat, optional
正の実数、デフォルトでは1.0です
- 属性:
- hn_mu_vecnumpy ndarray
実数のベクトル
- hn_lambda_matnumpy ndarray
正定値行列
- hn_alphafloat
正の実数
- hn_betafloat
正の実数
- p_mfloat
正の実数
- p_lambdafloat
正の実数
- p_nufloat
正の実数
メソッド
予測分布のパラメータを計算します。
estimate_params([loss])与えられた基準の下で、確率的データ生成モデルのパラメータを推定します。
LearnModel の定数を取得します。
事後分布のハイパーパラメータの初期値を取得します。
事後分布のハイパーパラメータを取得します。
予測分布のパラメータを取得します。
load_h0_params(filename)h0_paramsにハイパーパラメータをロードします。
load_hn_params(filename)hn_paramsにハイパーパラメータをロードします。
make_prediction([loss])与えられた基準の下で、新しいデータ点を予測します。
overwrite_h0_params()事後分布のハイパーパラメータの初期値を学習した値で上書きします。
pred_and_update(x[, loss])逐次的に新しいデータ点を予測し、事後分布を更新します。
predict_interval([credibility])予測の信頼区間
reset_hn_params()事後分布のハイパーパラメータを初期値に戻します。
save_h0_params(filename)python
pickleモジュールを使ってハイパーパラメータを保存します。save_hn_params(filename)python
pickleモジュールを使ってハイパーパラメータを保存します。set_h0_params([h0_mu_vec, h0_lambda_mat, ...])事後分布のハイパーパラメータの初期値を設定します。
set_hn_params([hn_mu_vec, hn_lambda_mat, ...])事後分布のハイパーパラメータの更新値を設定します。
update_posterior(x[, padding])訓練データを使って事後分布のハイパーパラメータを更新します。
パラメータの事後分布を可視化します。
- get_constants()#
LearnModel の定数を取得します。
- 返り値:
- constantsdict of {str: int}
"c_degree":``self.c_degree``の値
- set_h0_params(h0_mu_vec=None, h0_lambda_mat=None, h0_alpha=None, h0_beta=None)#
事後分布のハイパーパラメータの初期値を設定します。
予測分布のパラメータも、
self.h0_mu_vec、slef.h0_lambda_mat、self.h0_alpha、および``self.h0_beta``から計算されることにご留意ください。- パラメータ:
- h0_mu_vecnumpy ndarray, optional
実数のベクトル、デフォルトではNone
- h0_lambda_matnumpy ndarray, optional
正定値行列、デフォルトではNone
- h0_alphafloat, optional
正の実数、デフォルトではNone
- h0_betafloat, optional
正の実数、デフォルトではNone
- get_h0_params()#
事後分布のハイパーパラメータの初期値を取得します。
- 返り値:
- h0_paramsdict of {str: float or numpy ndarray}
h0_mu_vec:self.h0_mu_vecの値h0_lambda_mat":self.h0_lambda_matの値"h0_alpha":self.h0_alphaの値"h0_beta":self.h0_betaの値
- get_hn_params()#
事後分布のハイパーパラメータを取得します。
- 返り値:
- hn_paramsdict of {str: float or numpy ndarray}
"hn_mu_vec":self.hn_mu_vecの値"hn_lambda_mat":self.hn_lambda_matの値"hn_alpha":self.hn_alphaの値"hn_beta":self.hn_betaの値
- set_hn_params(hn_mu_vec=None, hn_lambda_mat=None, hn_alpha=None, hn_beta=None)#
事後分布のハイパーパラメータの更新値を設定します。
予測分布のパラメータも、
self.hn_mu_vec、self.hn_lambda_mat、self.hn_alpha、および``self.hn_beta``から計算されることにご留意ください。- パラメータ:
- hn_mu_vecnumpy ndarray, optional
実数のベクトル、デフォルトではNone
- hn_lambda_matnumpy ndarray, optional
正定値行列、デフォルトではNone
- hn_alphafloat, optional
正の実数、デフォルトではNone
- hn_betafloat, optional
正の実数、デフォルトではNone
- update_posterior(x, padding=None)#
訓練データを使って事後分布のハイパーパラメータを更新します。
- パラメータ:
- xnumpy ndarray
1次元の浮動小数点数配列
- paddingstr, optional
負の時間点におけるデータ値のパディングオプションです。デフォルトは「None」であり、この場合「X」の最初の「self.c_degree」個の値が初期値として使用されます。もし「zeros」が指定された場合、ゼロベクトルが初期値として使用されます。
- estimate_params(loss='squared')#
与えられた基準の下で、確率的データ生成モデルのパラメータを推定します。
なお、この基準は「theta_vec」と「tau」をそれぞれ独立して推定する際に適用されます。したがって、loss="KL"の場合、スチューデントのt分布とガンマ分布の組が返されます。
- パラメータ:
- lossstr, optional
ベイズリスク関数の基礎となる損失関数、デフォルトは "squared"。この関数は "squared"、"0-1"、"abs"、"KL "をサポートしています。
- 返り値:
- Estimatestuple of {numpy ndarray, float, None, or rv_frozen}
theta_vec_hat: theta_vec の推定値tau_hat: tau の推定値
与えられた損失関数の下での推定値。存在しない場合は None が返されます。損失関数が "KL" の場合、事後分布そのものが scipy.stats の rv_frozen オブジェクトとして返されます。
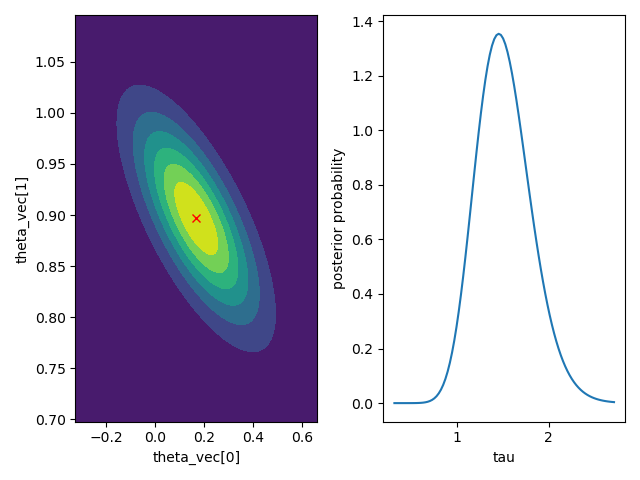
- visualize_posterior()#
パラメータの事後分布を可視化します。
例
>>> from bayesml import autoregressive
>>> gen_model = autoregressive.GenModel(c_degree=1,theta_vec=np.array([0,1]),tau=1.0)
>>> x = gen_model.gen_sample(50)
>>> learn_model = autoregressive.LearnModel()
>>> learn_model.update_posterior(x)
>>> learn_model.visualize_posterior()
- get_p_params()#
予測分布のパラメータを取得します。
- 返り値:
- p_paramsdict of {str: float}
"p_m":self.p_mの値"p_lambda":self.p_lambdaの値"p_nu":self.p_nuの値
- calc_pred_dist(x)#
予測分布のパラメータを計算します。
- パラメータ:
- xnumpy ndarray
1次元の浮動小数点数配列で、そのサイズは``self.c_degree``
- make_prediction(loss='squared')#
与えられた基準の下で、新しいデータ点を予測します。
- パラメータ:
- lossstr, optional
ベイズリスク関数の基礎となる損失関数、デフォルトは "squared"。この関数は "squared"、"0-1"、"abs"、"KL "をサポートしています。
- 返り値:
- Predicted_value{float, rv_frozen}
指定された損失関数に基づく予測値です。損失関数が「KL」の場合、予測分布そのものが scipy.stats の rv_frozen オブジェクトとして返されます。
- predict_interval(credibility=0.95)#
予測の信頼区間
- パラメータ:
- credibilityfloat, optional
パラメータがその区間に含まれるという事後確率(デフォルト値:0.95)
- 返り値:
- lower, upper: float
区間の下限と上限
- pred_and_update(x, loss='squared')#
逐次的に新しいデータ点を予測し、事後分布を更新します。
- パラメータ:
- xnumpy ndarray
1次元の浮動小数点数配列で、そのサイズは``self.c_degree + 1``となります。この配列は、``self.c_degree``個の過去の値と現在の値で構成されています。
- lossstr, optional
ベイズリスク関数の基礎となる損失関数、デフォルトは "squared"。この関数は "squared"、"0-1"、"abs"、"KL "をサポートしています。
- 返り値:
- Predicted_value{float, rv_frozen}
指定された損失関数に基づく予測値です。損失関数が「KL」の場合、予測分布そのものが scipy.stats の rv_frozen オブジェクトとして返されます。