bayesml.contexttree package#
モジュール内容#
このモジュールでは文脈木モデルとその共役事前分布を利用できます。
確率的データ生成モデル#
確率的データ生成モデルは以下の通りです:
\(\mathcal{X}=\{1,2,\ldots,K\}\) : 情報源シンボルの集合
\(x^n = x_1 x_2 \cdots x_n \in \mathcal{X}^n~(n\in\mathbb{N})\) : 情報源系列
\(D_\mathrm{max} \in \mathbb{N}\) : 文脈木モデルの最大深さ
\(T\):文脈木モデルであり、深さが \(D_\mathrm{max}\) 以下である正則 \(K\) 分木です。ここで、「正則」とは、すべての内部ノードが \(K\) 個の子ノードを持つことを意味します
\(\mathcal{T}\) : :math:`T`の集合
\(s\) :文脈木モデルのノード
\(\mathcal{I}(T)\) : \(T\) の内部ノードの集合
\(\mathcal{L}(T)\) : \(T\) の葉ノードの集合
\(\mathcal{S}(T)\):\(T`のすべてのノードの集合、すなわち、:math:\)mathcal{S}(T) = mathcal{I}(T) cup mathcal{L}(T)`
\(s_T(x^{n-1}) \in \mathcal{L}(T)\):\(x^{n-1} = x_1 x_2\cdots x_{n-1}\) に対応する \(T\) の葉ノード
\(\boldsymbol{\theta}_s = (\theta_{1|s}, \theta_{2|s}, \ldots, \theta_{K|s})\):葉ノード上のパラメータ。ただし \(\theta_{k|s}\) は \(k\in\mathcal{X}\) の生起確率を表します。
事前分布#
事前分布は以下の通りです:
\(g_{0,s} \in [0,1]\):\(s \in \mathcal{S}(T)\) に割り当てられたハイパーパラメータ
\(\beta_0(k|s) \in\mathbb{R}_{>0}\) : ディリクレ分布のハイパーパラメータ
\(\boldsymbol{\beta}_0(s) = (\beta_0(1|s), \beta_0(2|s), \ldots, \beta_0(K|s)) \in\mathbb{R}^{K}_{>0}\)
\(C(\boldsymbol{\beta}_0(s)) = \frac{\Gamma\left(\sum_{k=1}^{K} \beta_0(k|s)\right)}{\prod_{k=1}^{K} \Gamma\left(\beta_0(k|s)\right)}\)
\(s\in\mathcal{L}(T)\) における \(\boldsymbol{\theta}_s\) について、事前分布としてディリクレ分布が次のように仮定されます:
\(T \in \mathcal{T}\) に対して
ここで、\(s\) の深さが \(D_\mathrm{max}\) である場合、\(g_{0,s}=0\) となります。
事後分布#
事後分布は以下の通りです:
\(g_{n,s} \in [0,1]\) : 更新されたハイパーパラメータ
\(T_\mathrm{max}\):重ね合わせ文脈木(すべての文脈木モデルを重ね合わせた深さが \(D_\mathrm{max}\) である \(K\) 分完全木)
\(s_\lambda\) : 根ノード
\(\beta_n(k|s) \in\mathbb{R}_{>0}\):事後ディリクレ分布のハイパーパラメータ
\(\boldsymbol{\beta}_n(s) = (\beta_n(1|s), \beta_n(2|s), \ldots, \beta_n(K|s)) \in\mathbb{R}^{K}_{>0}\)
\(I \{ \cdot \}\): 指標関数
\(\boldsymbol{\theta}_s \in\mathcal{L}(T_\mathrm{max})\) に対して
ハイパーパラメータの更新ルールは以下の通りです:
\(T \in \mathcal{T}\) に対して
ハイパーパラメータの更新ルールは以下の通りです:
ここで、\(s_{\mathrm{child}}\) は、\(s_\lambda\) から \(s_{T_\mathrm{max}}(x^n)\) への経路上の \(s\) の子ノードであり
ただし
予測分布#
予測分布は以下の通りです:
\(\boldsymbol{\theta}_\mathrm{p} = (\theta_{\mathrm{p},1}, \theta_{\mathrm{p},2}, \ldots, \theta_{\mathrm{p},K})\):予測分布のパラメータであり、 \(\theta_{\mathrm{p},k}\) は \(k\in\mathcal{X}\) の生起確率を表します。
ここで、予測分布のパラメータの更新規則は以下の通りです。
参照
Matsushima, T.; and Hirasawa, S. Reducing the space complexity of a Bayes coding algorithm using an expanded context tree, 2009 IEEE International Symposium on Information Theory, 2009, pp. 719-723, https://doi.org/10.1109/ISIT.2009.5205677
Nakahara, Y.; Saito, S.; Kamatsuka, A.; Matsushima, T. Probability Distribution on Full Rooted Trees. Entropy 2022, 24, 328. https://doi.org/10.3390/e24030328
GitHubスターのお願い#

クラス#
- class bayesml.contexttree.GenModel(c_k, c_d_max=2, root=None, h_g=0.5, h_beta_vec=None, h_root=None, seed=None)#
ベースクラス:
Generative確率的データ生成モデルと事前分布
- パラメータ:
- c_kint
正の整数
- c_d_maxint, オプション
正の整数(デフォルトは10)
- rootcontexttree._Node, optional
文脈木の根ノードです。デフォルトでは、木は1つのノードのみで構成されます。
- h_gfloat, optional
0以上1以下の実数で、デフォルトは 0.5 です
- h_beta_vecnumpy.ndarray, optional
正の実数のベクトルであり、デフォルトでは [1/2, 1/2, ..., 1/2] となります。単一の実数が入力された場合、ブロードキャスト処理が行われます。
- h_rootcontexttree._Node, optional
ハイパーパラメータ用の重ね合わせ木の根ノード。デフォルトは
Noneです。- seed{None, int}, optional
numpy.random.default_rng() を初期化するシード値です。デフォルトでは None
メソッド
gen_params([tree_fix])事前分布からパラメータを生成します。
gen_sample(sample_length[, initial_values])確率的データ生成モデルからサンプルを生成します。
GenModel の定数を取得します。
事前分布のハイパーパラメータを取得します。
確率的データ生成モデルのパラメータを取得します。
load_h_params(filename)h_paramsにハイパーパラメータをロードします。
load_params(filename)save_paramsに保存されたパラメータをロードします。save_h_params(filename)python
pickleモジュールを使ってハイパーパラメータを保存します。save_params(filename)python の
pickleモジュールを使ってパラメータを保存します。save_sample(filename, sample_length[, ...])生成されたサンプルを NumPy
.npzフォーマットで保存します。set_h_params([h_g, h_beta_vec, h_root])事前分布のハイパーパラメータを設定します。
set_params([root])確率的データ生成モデルのパラメータを設定します。
visualize_model([filename, format, ...])確率的データ生成モデルと生成されたサンプルを可視化します。
- get_constants()#
GenModel の定数を取得します。
- set_h_params(h_g=None, h_beta_vec=None, h_root=None)#
事前分布のハイパーパラメータを設定します。
- パラメータ:
- h_gfloat, optional
\([0, 1]\) 内の実数。デフォルトは
Noneです- h_beta_vecnumpy.ndarray, optional
正の実数のベクトル。デフォルトは
Noneです- h_rootcontexttree._Node, optional
ハイパーパラメータ用の重ね合わせ木の根ノード。デフォルトは
Noneです。
- get_h_params()#
事前分布のハイパーパラメータを取得します。
- gen_params(tree_fix=False)#
事前分布からパラメータを生成します。
生成された値は
self.rootに設定されます。- パラメータ:
- tree_fixbool
「True」の場合、木の形状は固定されます。デフォルトは「False」です。
- set_params(root=None)#
確率的データ生成モデルのパラメータを設定します。
- パラメータ:
- rootcontexttree._Node, optional
文脈木の根ノードです。デフォルトでは None です。
- get_params()#
確率的データ生成モデルのパラメータを取得します。
- 返り値:
- paramsdict of {str:float}
"root":self.rootの値です。
- gen_sample(sample_length, initial_values=None)#
確率的データ生成モデルからサンプルを生成します。
- パラメータ:
- sample_lengthint
正の整数
- initial_valulesnumpy ndarray, optional
「self.c_d_max」と同じサイズの1次元整数配列です。デフォルトは「None」です。その要素は [0, c_k-1] の範囲内である必要があります
- 返り値:
- xnumpy ndarray
サイズが「sample_length」の1次元整数配列です。
- save_sample(filename, sample_length, initial_values=None)#
生成されたサンプルを NumPy
.npzフォーマットで保存します。キーワード "x "でNpzFileとして保存されます。
- パラメータ:
- filenamestr
サンプルを保存するファイル名。ない場合は
.npzが追加されます。- sample_lengthint
正の整数
- initial_valulesnumpy ndarray, optional
「self.c_d_max」と同じサイズの1次元整数配列です。デフォルトは「None」です。その要素は [0, c_k-1] の範囲内である必要があります
- visualize_model(filename=None, format=None, sample_length=10)#
確率的データ生成モデルと生成されたサンプルを可視化します。
- パラメータ:
- filenamestr, optional
図を保存する際のファイル名。デフォルトは「None」です
- formatstr, optional
レンダリングの出力形式(「pdf」、 「png」など)。
- sample_lengthint, オプション
正の整数(デフォルトは10)
例
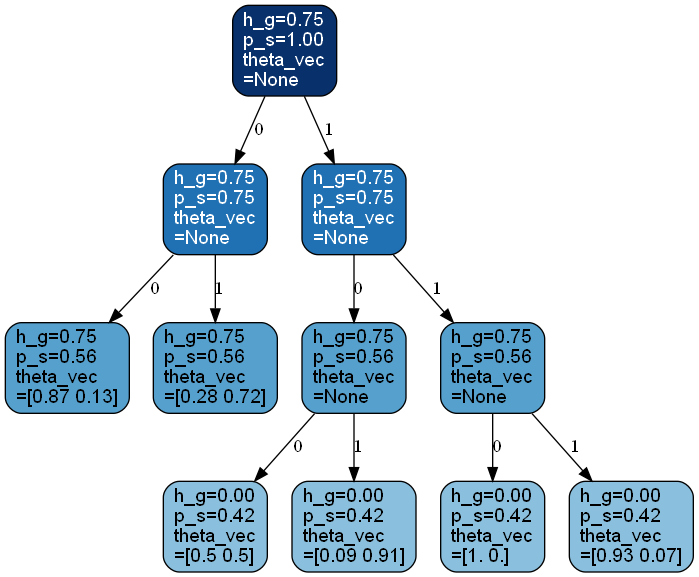
>>> from bayesml import contexttree
>>> gen_model = contexttree.GenModel(c_k=2,c_d_max=3,h_g=0.75)
>>> gen_model.gen_params()
>>> gen_model.visualize_model()
[1 0 1 0 0 0 1 0 0 0]
- class bayesml.contexttree.LearnModel(c_k, c_d_max=2, h0_g=0.5, h0_beta_vec=None, h0_root=None)#
ベースクラス:
Posterior,PredictiveMixin事後分布と予測分布
- パラメータ:
- c_kint
正の整数
- c_d_maxint, オプション
正の整数(デフォルトは10)
- h0_gfloat, optional
0以上1以下の実数で、デフォルトは 0.5 です
- h0_beta_vecnumpy.ndarray, optional
正の実数のベクトルであり、デフォルトでは [1/2, 1/2, ..., 1/2] となります。単一の実数が入力された場合、ブロードキャスト処理が行われます。
- h0_rootcontexttree._Node, optional
ハイパーパラメータ用の重ね合わせ木の根ノード。デフォルトは
Noneです。
- 属性:
- hn_gfloat
:math:`[0, 1]`に属する実数
- hn_beta_vecnumpy.ndarray
正の実数のベクトル
- hn_rootcontexttree._Node
ハイパーパラメータ用の重ね合わせ木の根ノードです
メソッド
予測分布のパラメータを計算します。
estimate_params([loss, visualize, filename, ...])与えられた基準に基づいたパラメータ推定
LearnModel の定数を取得します。
事前分布のハイパーパラメータを取得します。
事後分布のハイパーパラメータを取得します。
予測分布のパラメータを取得します。
load_h0_params(filename)h0_paramsにハイパーパラメータをロードします。
load_hn_params(filename)hn_paramsにハイパーパラメータをロードします。
make_prediction([loss])与えられた基準の下で、新しいデータ点を予測します。
overwrite_h0_params()事後分布のハイパーパラメータの初期値を学習した値で上書きします。
pred_and_update(x[, loss])逐次的に新しいデータ点を予測し、事後分布を更新します。
reset_hn_params()事後分布のハイパーパラメータを初期値に戻します。
save_h0_params(filename)python
pickleモジュールを使ってハイパーパラメータを保存します。save_hn_params(filename)python
pickleモジュールを使ってハイパーパラメータを保存します。set_h0_params([h0_g, h0_beta_vec, h0_root])事前分布のハイパーパラメータを設定します。
set_hn_params([hn_g, hn_beta_vec, hn_root])事後分布のハイパーパラメータを設定します。
訓練データを使用してハイパーパラメータを更新します。
visualize_posterior([filename, format, h_params])パラメータの事後分布を可視化します。
- get_constants()#
LearnModel の定数を取得します。
- set_h0_params(h0_g=None, h0_beta_vec=None, h0_root=None)#
事前分布のハイパーパラメータを設定します。
- パラメータ:
- h0_gfloat, optional
\([0, 1]\) 内の実数。デフォルトは
Noneです- h0_beta_vecnumpy.ndarray, optional
正の実数のベクトル。デフォルトは
Noneです- h0_rootcontexttree._Node, optional
ハイパーパラメータ用の重ね合わせ木の根ノード。デフォルトは
Noneです。
- get_h0_params()#
事前分布のハイパーパラメータを取得します。
- set_hn_params(hn_g=None, hn_beta_vec=None, hn_root=None)#
事後分布のハイパーパラメータを設定します。
- パラメータ:
- hn_gfloat, optional
\([0, 1]\) 内の実数。デフォルトは
Noneです- hn_beta_vecnumpy.ndarray, optional
正の実数のベクトル。デフォルトは
Noneです- hn_rootcontexttree._Node, optional
ハイパーパラメータ用の重ね合わせ木の根ノード。デフォルトは
Noneです。
- get_hn_params()#
事後分布のハイパーパラメータを取得します。
- update_posterior(x)#
訓練データを使用してハイパーパラメータを更新します。
- パラメータ:
- xnumpy ndarray
1次元の整数配列
- estimate_params(loss='0-1', visualize=True, filename=None, format=None)#
与えられた基準に基づいたパラメータ推定
- パラメータ:
- lossstr, optional
ベイズリスク関数の基礎となる損失関数で、デフォルトでは
"0-1"です。この関数は"0-1"のみをサポートしています。- visualizebool, optional
「True」の場合、推定された文脈木モデルが可視化されます。デフォルトでは「True」です。この可視化には「graphviz」が必要です。
- filenamestr, optional
図を保存する際のファイル名。デフォルトは「None」です
- formatstr, optional
レンダリングの出力形式(「pdf」、 「png」など)。
- 返り値:
- map_rootcontexttree._Node
推定された文脈木モデルの根ノードであり、各ノードには推定されたパラメータも含まれています。
- visualize_posterior(filename=None, format=None, h_params=False)#
パラメータの事後分布を可視化します。
この方法には「graphviz」が必要です。
- パラメータ:
- filenamestr, optional
図を保存する際のファイル名。デフォルトは「None」です
- formatstr, optional
レンダリングの出力形式(「pdf」、 「png」など)。
- h_paramsbool, optional
「True」の場合、各ノードのハイパーパラメータが表示されます。「False」の場合、各ノードの推定パラメータが表示されます。
例
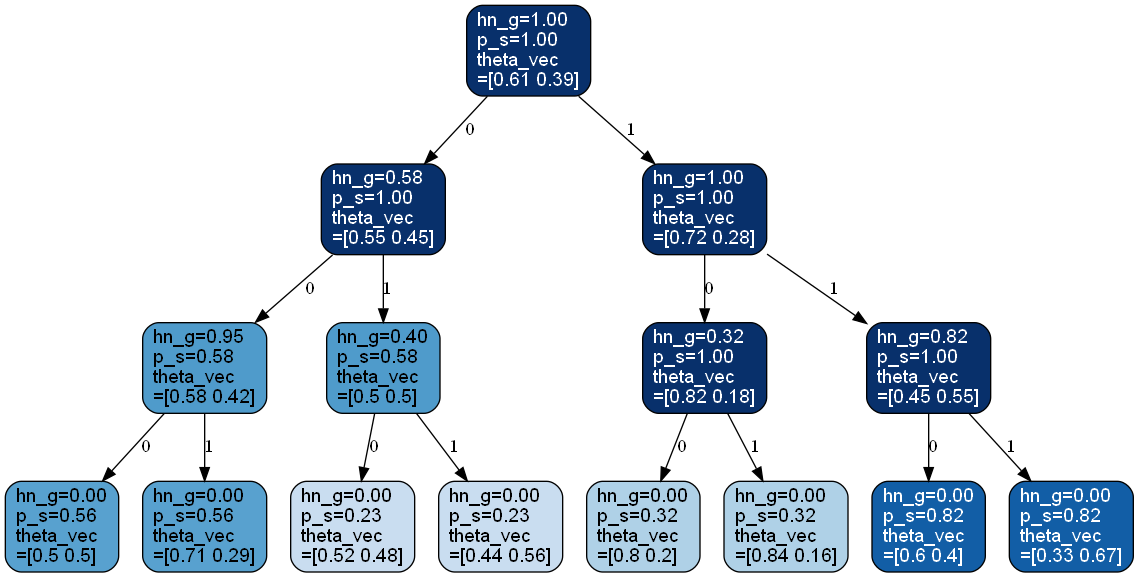
>>> from bayesml import contexttree
>>> gen_model = contexttree.GenModel(c_k=2,c_d_max=3,h_g=0.75)
>>> gen_model.gen_params()
>>> x = gen_model.gen_sample(500)
>>> learn_model = contexttree.LearnModel(c_k=2,c_d_max=3,h0_g=0.75)
>>> learn_model.update_posterior(x)
>>> learn_model.visualize_posterior()
- get_p_params()#
予測分布のパラメータを取得します。
- 返り値:
- p_paramsdict of {str: numpy.ndarray}
"p_theta_vec":self.p_theta_vecの値
- calc_pred_dist(x)#
予測分布のパラメータを計算します。
- パラメータ:
- xnumpy ndarray
1次元の整数配列
- make_prediction(loss='KL')#
与えられた基準の下で、新しいデータ点を予測します。
- パラメータ:
- lossstr, optional
ベイズリスク関数の基礎となる損失関数で、デフォルトは「KL」です。この関数は「KL」と「0-1」に対応しています。
- 返り値:
- predicted_value{float, numpy.ndarray}
指定された損失関数に基づく予測値です。損失関数が「KL」の場合、予測分布は出現確率からなる1次元のnumpy.ndarrayとして返されます。
- pred_and_update(x, loss='KL')#
逐次的に新しいデータ点を予測し、事後分布を更新します。
- パラメータ:
- xnumpy.ndarray
1次元の整数配列
- lossstr, optional
ベイズリスク関数の基礎となる損失関数で、デフォルトは「KL」です。この関数は「KL」および「0-1」をサポートしています。
- 返り値:
- predicted_value{float, numpy.ndarray}
与えられた損失関数に基づく予測値です。